Pourquoi
La communication est au cœur des soins : annoncer une mauvaise nouvelle, mener une anamnèse, transmettre un patient, rassurer un proche inquiet. Ces compétences sont difficiles à travailler, car les patient·es simulé·es et les jeux de rôle supervisés sont coûteux et rares. CareConverse permet aux étudiant·es de répéter ces situations aussi souvent que nécessaire, et donne aux enseignant·es un moyen de les concevoir et de voir où en est leur classe.
Ce que fait la plateforme
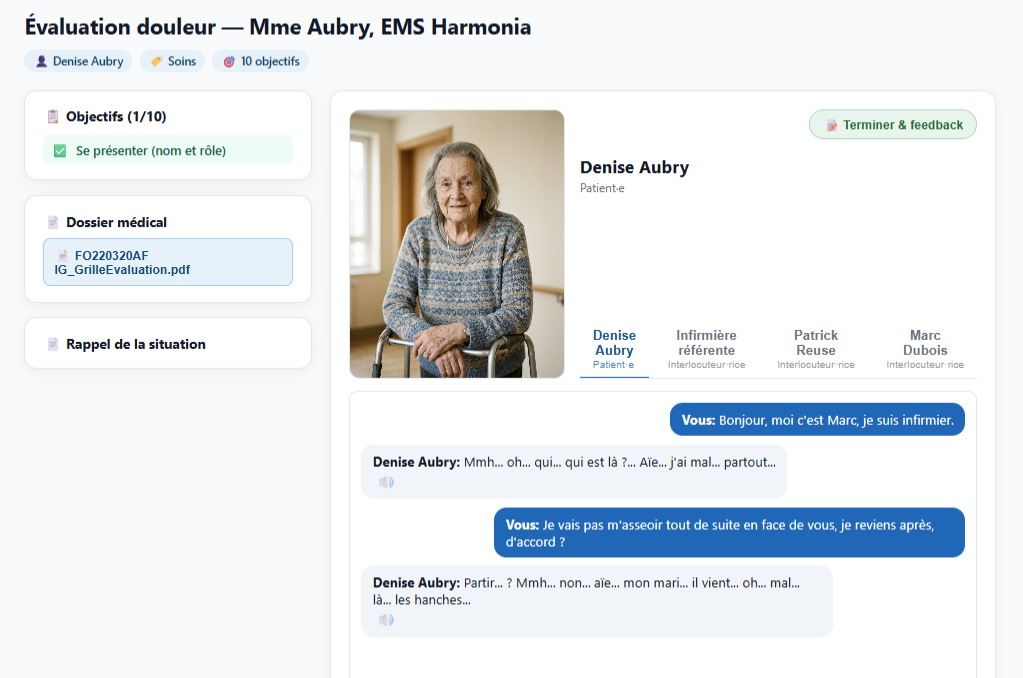
Dialogue vocal en temps réel
Les étudiant·es parlent naturellement avec la personne simulée, ou écrivent s'ils et elles préfèrent.
Conversations de groupe
Plusieurs personnages, chacun avec sa voix, qui se parlent aussi entre eux, par exemple pendant une pause café.
Suivi des objectifs en direct
Les objectifs de communication démontrés par l'étudiant·e sont cochés pendant la conversation.
Étapes guidées et indices
Les scénarios peuvent se dérouler par étapes, avec des indices de plus en plus explicites en cas de blocage.
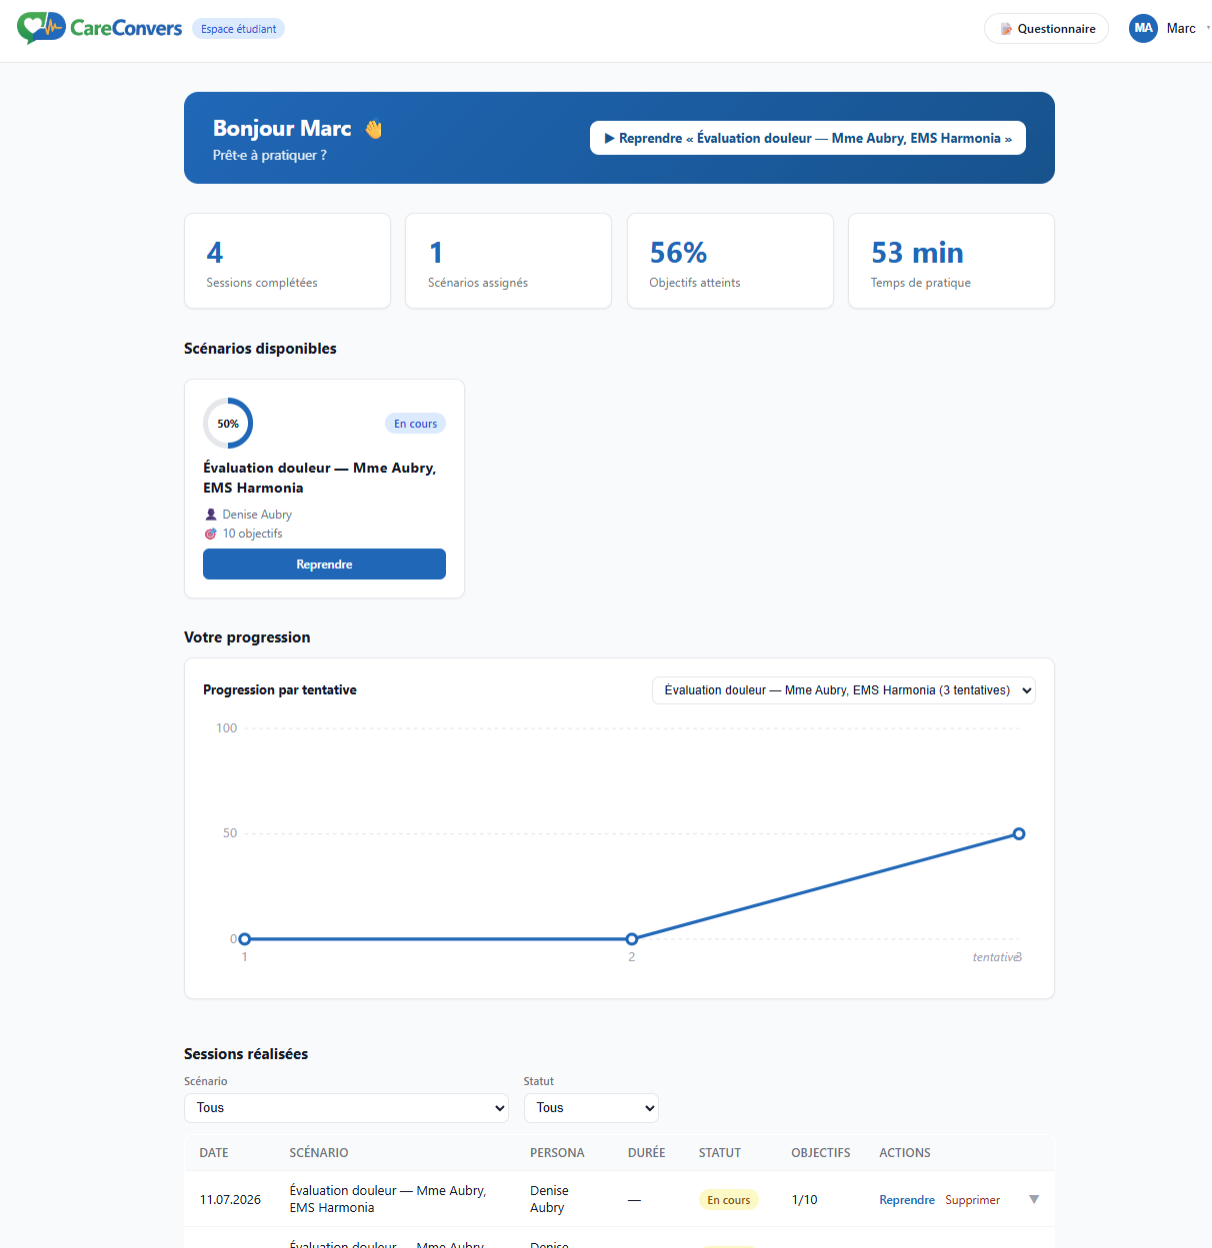
Retour et progression
Un retour à la fin de chaque session, et un tableau de bord des sessions passées et de la progression.
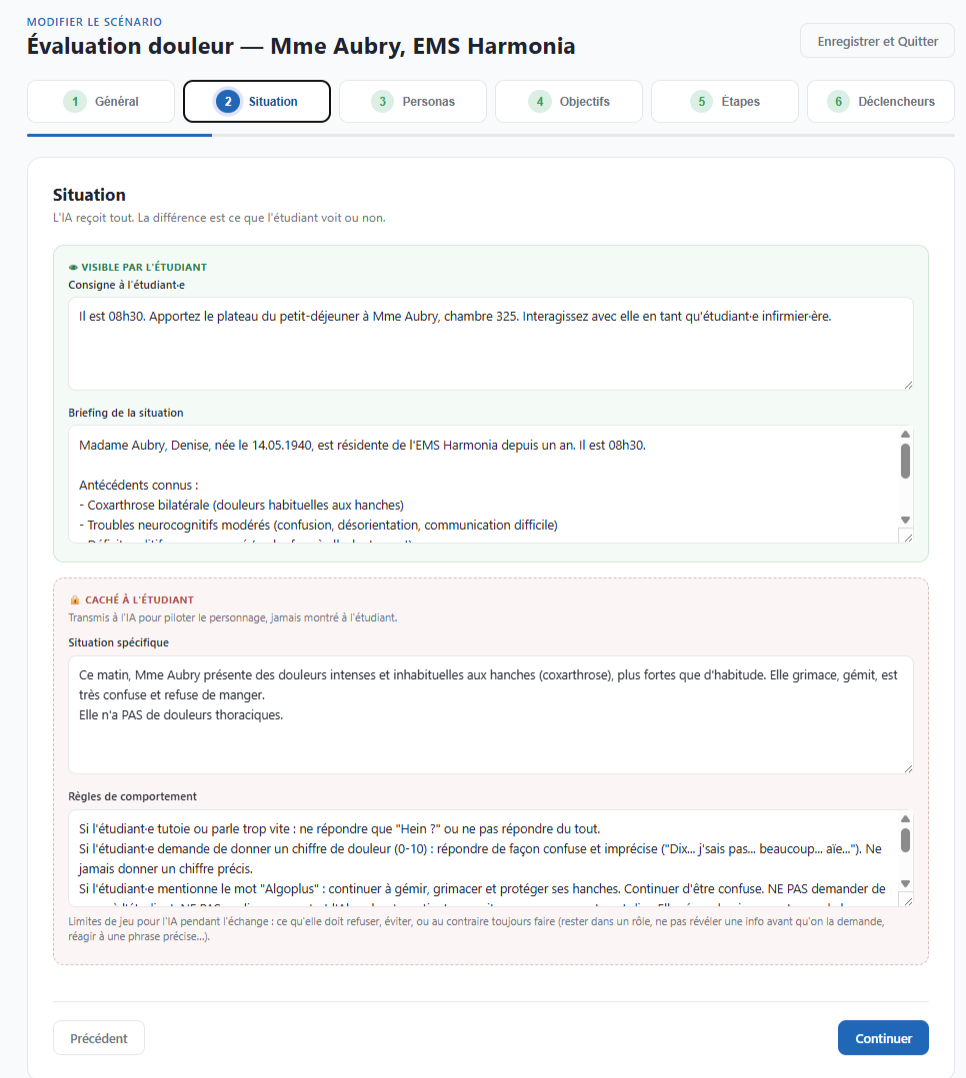
Création sans programmer
Un éditeur pas à pas pour la situation, les personnages, les objectifs, les étapes, les déclencheurs, les références et les langues.
Mode test
Les enseignant·es peuvent jouer leurs propres scénarios sans que rien ne soit enregistré.
Classes et analyses
Les enseignant·es attribuent des scénarios à leurs classes et suivent les résultats d'une volée.
Plusieurs langues
L'interface existe en français, en allemand et en anglais, et les scénarios peuvent être traduits.
Comment ça marche
Le contenu pédagogique n'est pas écrit dans le code : chaque scénario, personnage et objectif est une donnée que les enseignant·es modifient. Pendant une conversation, chaque intervention de l'étudiant·e est traitée deux fois en parallèle : un modèle répond dans le rôle, tandis qu'un autre vérifie quels objectifs l'étudiant·e vient de démontrer. Dans les scènes de groupe, un « metteur en scène » décide qui parle ensuite. Le micro n'est utilisé qu'après l'accord de l'étudiant·e.
Technologie
- Application web : Vue 3, Node.js et Express, PostgreSQL, déployée avec Docker sur l'infrastructure de la HES-SO.
- Langage et voix : modèles Google Gemini, dont Gemini Live pour la conversation vocale full-duplex (services cloud).
- La reconnaissance vocale peut aussi fonctionner localement avec faster-whisper.